1.Contexte
Réécrire un monolithe d’un coup, c’est le genre de pari qu’on ne fait qu’une fois, généralement parce que ça se passe mal. Projet de plusieurs mois, fonctionnalités gelées, règles métier oubliées qui refont surface à J-1 de la mise en production… Le pattern Strangler Fig propose une autre voie : migrer petit bout par petit bout, en laissant l’ancien et le nouveau système cohabiter le temps qu’il faut.
Le nom vient de Martin Fowler, qui a baptisé et popularisé le pattern en 2004, et d’une image botanique assez parlante, à condition de la raconter correctement. Le figuier étrangleur n’est pas une liane qui grimperait depuis le sol : c’est un hémiépiphyte. Sa graine est déposée par un oiseau dans la canopée, elle germe donc en hauteur, puis l’arbre fait descendre ses racines le long du tronc de son hôte, l’enserre progressivement en descendant, et finit par le remplacer entièrement. Ça commence en haut, ça enserre en descendant.
La transposition est directe : l’arbre hôte, c’est le monolithe, les racines qui descendent, ce sont les nouveaux services qu’on branche autour de lui, un par un, jusqu’à ce que le legacy n’ait plus de raison d’exister.
Cet article couvre l’intérêt du pattern, ses avantages, ses limites, et une mise en œuvre concrète en .NET 10 avec YARP comme façade de routage. Une variante événementielle est traitée en fin d’article, pour les monolithes qui communiquent par messages plutôt que par HTTP.
Précision de cadrage, pour éviter tout malentendu en cours de lecture : le monolithe MVC de l’exemple qui suit a déjà fait l’objet, en amont et sur un chantier séparé, d’une refonte complète de son front sur une techno dédiée (SPA, JS moderne, peu importe laquelle). La question de la migration des vues elle-même ne sera donc pas traitée ici : elle mériterait un article à part entière, et mélanger les deux sujets n’aiderait personne. Ce qu’on étrangle dans cet article, c’est le backend.
2.Qu’est-ce que le pattern Strangler Fig ?
Le principe tient en une phrase : au lieu de tout réécrire, on place une façade devant l’existant, et on migre les fonctionnalités une par une derrière elle. La façade (proxy, gateway, reverse proxy) route chaque requête vers l’ancien système ou vers le nouveau composant fraîchement développé. À chaque extraction, on branche la route, on retire le code équivalent du monolithe, et on recommence, jusqu’à ce qu’il ne reste plus rien à étrangler.
La formulation la plus répandue résume la démarche en trois mouvements, répétés en boucle : Transform (construire le nouveau composant), Coexist (faire cohabiter ancien et nouveau, routage à l’appui), Eliminate (supprimer le code devenu mort). Une précision d’attribution s’impose : ce triptyque n’est pas de Fowler, qui décrit de son côté quatre activités de plus haut niveau. Il vient de Paul Hammant, dans « Legacy Application Strangulation : Case Studies » (2013), référence donnée en fin d’article. Simple sur le papier, la difficulté est ailleurs, comme on le verra plus loin.
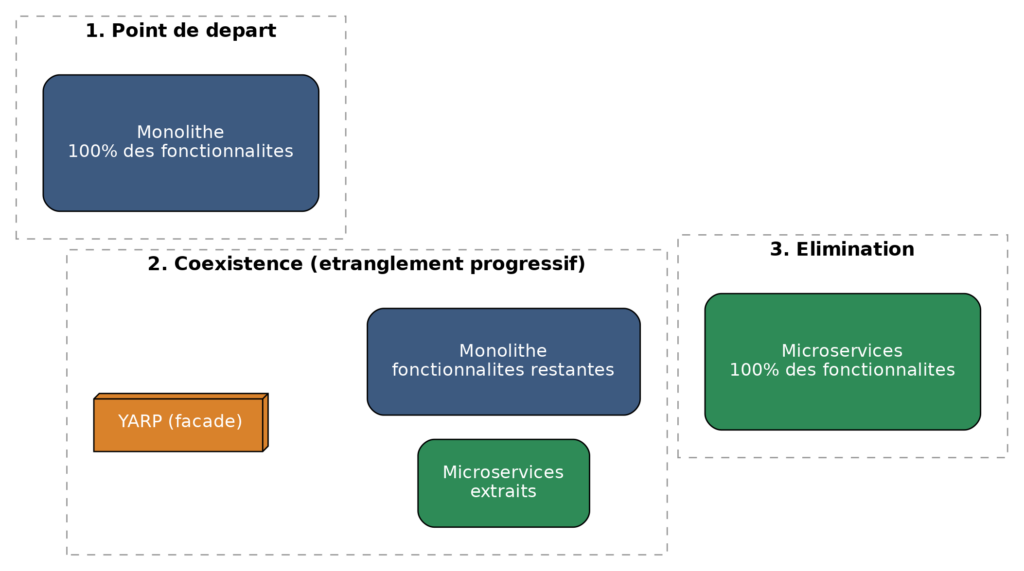
Les trois phases du Strangler Fig : le monolithe rétrécit pendant que la cible grandit, jusqu’à disparaître complètement. Cette cible peut être un microservice, un service applicatif classique ou un simple module extrait, c’est un choix de contexte, pas une obligation du pattern.
3.Pourquoi adopter ce pattern
Une réécriture big bang, c’est un pari : une équipe immobilisée pendant des mois, aucune livraison intermédiaire, et surtout aucun plan B si le nouveau système déraille le jour de la bascule. Le Strangler Fig inverse la logique, on ne joue jamais l’intégralité du système sur un unique go/no-go, et chaque étape reste réversible.
L’argument qui emporte la décision est d’ailleurs moins technique que financier. Sur un système ancien (ASP.NET WebForms, .NET Framework…) qui continue de générer du chiffre d’affaires, personne ne finance une réécriture totale assortie d’un gel fonctionnel de dix-huit mois. Une migration incrémentale, elle, se budgète module par module et reste arbitrable à chaque étape : c’est souvent la seule option réaliste, pas seulement la plus élégante.
Reste la question de l’ordre de bataille. Quoi migrer en premier dépend du contexte, la valeur business s’il faut convaincre un sponsor rapidement, la friction ou le risque technique si la stabilité prime, mais toujours avec une frontière métier nette et un risque maîtrisé. La section consacrée à la cartographie y revient en détail, le bilan bénéfices/limites, lui, est résumé dans les deux tableaux qui suivent.
4.Le Strangler Fig face aux autres stratégies de migration
Le Strangler Fig n’est pas la seule option sur la table. Le situer par rapport aux alternatives aide à justifier le choix, utile face à une direction technique qui demande « pourquoi pas une réécriture, tout simplement ? »
| Stratégie | Principe et quand l’envisager |
| Big Bang (réécriture complète) | Tout est réécrit puis basculé en une fois. Réservé aux systèmes petits, peu critiques, ou déjà voués à disparaître : le risque d’un go/no-go unique est difficilement justifiable ailleurs. |
| Parallel Run | Ancien et nouveau système tournent sur l’intégralité du périmètre, résultats comparés avant bascule totale. Pertinent quand l’exactitude prime absolument (calculs financiers, paie) et qu’aucune divergence n’est tolérable. |
| Migration pilotée par les données | On migre d’abord le stockage (nouvelle base, nouveau schéma), le code applicatif suit ensuite. Utile quand le vrai verrou est la base de données legacy, pas le code qui l’utilise. |
| Strangler Fig | Extraction progressive module par module, derrière une façade de routage. Adapté aux systèmes complexes et actifs, où un big bang serait trop risqué et où la valeur doit être livrée en continu. |
Ces approches ne s’excluent pas forcément : un Strangler Fig peut très bien intégrer un Parallel Run ponctuel sur un module sensible, c’est exactement le rôle du traffic mirroring vu plus loin, ou s’appuyer sur une migration de données préalable avant d’attaquer le code applicatif.
5.Avantages
| Avantage | En pratique |
| Risque maîtrisé | Périmètre réduit à chaque migration : un problème, on repointe la route vers le legacy, le reste du système ne bouge pas. |
| Valeur livrée en continu | Chaque module migré est une victoire livrée, pas une promesse pour dans deux ans. |
| Coexistence testée en prod | Le nouveau composant encaisse du vrai trafic avant que le legacy ne parte à la retraite. |
| Montée en compétence progressive | L’équipe apprivoise .NET 10 et une architecture découplée, microservice ou non, sur un périmètre limité, avant de généraliser. |
| Priorisation flexible | On migre ce qui compte, dans l’ordre qu’on choisit, pas celui imposé par un big bang. |
| Pas de gel fonctionnel | Le legacy continue de vivre (correctifs, petites évolutions) pendant toute la transition. |
6.Inconvénients et points de vigilance
| Inconvénient | Impact / mitigation |
| Durée étendue | Ça peut courir sur plusieurs mois, voire années. Il faut un sponsor qui tienne la distance. |
| Complexité de la façade | YARP devient un composant critique : sécurité, supervision, haute dispo, pas une option. |
| Synchronisation des données | Deux bases qui se regardent en chien de faïence : lecture miroir, outbox, CDC, événements… à choisir selon le couplage. |
| Double maintenance | Deux systèmes à faire vivre en parallèle : bugs, dépendances, infra, des deux côtés. |
| Dette organisationnelle | Sans discipline, la phase Eliminate glisse indéfiniment et le legacy s’installe pour de bon. |
| Routage qui se complexifie | Plus on ajoute de règles (chemin, en-tête, tenant…), plus la config devient difficile à auditer. |
7.Décisionnaires : quel ordre de grandeur budgétaire ?
« Un sponsor qui tienne la distance », c’est vite dit : encore faut-il pouvoir lui annoncer une échelle. Les fourchettes ci-dessous ne sont pas un chiffrage, elles dépendent de la taille de l’équipe, de l’état du legacy et de la maturité de l’outillage existant, mais elles donnent une base de discussion honnête pour un module du type Commandes détaillé plus loin, avec une équipe de trois à cinq personnes et des sprints de deux semaines.
| Étape | Ordre de grandeur |
| Façade neutre (YARP devant le legacy) | 1 à 2 sprints. Peu de code, mais du réseau, des certificats, des en-têtes transférés à valider et une mise en production à blanc à sécuriser. |
| Cartographie et choix du premier module | Environ 1 sprint, souvent mené en parallèle : ateliers avec le métier, relevé des dépendances, arbitrage sur la stratégie de données. |
| Première extraction complète | 3 à 6 sprints, bascule progressive comprise. C’est là qu’on paie l’apprentissage : CI/CD, observabilité, tests de contrat, synchronisation des données. |
| Extractions suivantes | Sensiblement moins à périmètre comparable : l’outillage est déjà en place, seul le métier reste à traiter. |
| Phase Eliminate (par module) | De quelques jours à un sprint. C’est la ligne qu’on oublie systématiquement de budgéter, et celle qui décide si la migration s’achève vraiment. |
Deux messages à faire passer au sponsor. D’abord, la première extraction coûte structurellement plus cher que les suivantes : on y finance l’outillage commun, pas seulement un module. Ensuite, la durée totale se compte en trimestres, pas en semaines. Un sponsor à qui on explique ces deux points tiendra la distance, un sponsor à qui on a promis trois mois lâchera l’affaire au premier trimestre.
8.Cartographie préalable : trouver la bonne coupure
Avant de sortir la façade et de choisir un module à extraire, un détour par la cartographie évite bien des mauvaises surprises. L’idée, empruntée au Domain-Driven Design : découper le monolithe en bounded contexts, des frontières métier cohérentes (Commandes, Catalogue, Facturation…) plutôt que des découpes techniques héritées de l’historique du code.
Un atelier d’Event Storming avec les équipes métier et technique suffit souvent à faire émerger ces frontières : on rejoue les événements métier (commande créée, paiement validé, stock décrémenté…) et on regroupe ce qui évolue ensemble, en séparant ce qui varie de façon indépendante.
Le candidat idéal pour une première extraction coche trois cases : une frontière métier relativement nette (peu d’allers-retours avec le reste), une valeur business visible (pour justifier l’investissement), et un risque technique maîtrisé, pas le cœur nucléaire du système au premier essai. Un module Commandes, celui que nous détaillerons plus loin, correspond typiquement à ce profil, ce qui n’est pas tout à fait un hasard de choix pédagogique.
9.Modules imbriqués : gérer la duplication temporaire
Même avec une cartographie soignée en amont, un monolithe garde des zones grises. Un module Commandes appelle des règles partagées avec le Compte client, qui dépend lui-même du Catalogue pour calculer un prix… Extraire « juste » un module revient souvent à tirer un fil dans un pull. Quatre stratégies permettent de s’en sortir, chacune avec son prix à payer :
| Stratégie | Quand l’utiliser |
| Dupliquer temporairement | Logique simple ou peu sollicitée, transition courte. On assume la dette, avec un ticket et une date de suppression. |
| Rappeler le monolithe (via anti-corruption layer) | Logique encore instable ou modifiée souvent. Une seule source de vérité, au prix d’une dépendance réseau temporaire vers le legacy. |
| Extraire un socle partagé (shared kernel) | Logique stable et rarement retouchée (calculs, énumérations métier). Package partagé consommé des deux côtés. |
| Créer la coupure avant d’extraire (branch by abstraction) | Couplage fort et durable. On introduit une interface dans le monolithe, on bascule les appelants dessus, puis on branche le nouveau service derrière. |
Un mot sur l’anti-corruption layer, puisque le terme revient souvent : ce n’est pas un synonyme d' »appel HTTP vers le legacy ». C’est une couche de traduction, placée dans le nouveau service, à sa frontière avec le monolithe. Elle convertit le modèle legacy (tables dénormalisées, statuts numériques hérités, champs fourre-tout réutilisés pour trois usages différents) vers le modèle de domaine propre du nouveau service, et inversement. Sans elle, c’est le modèle legacy qui fuite dans le nouveau code, et l’extraction n’aura servi qu’à déménager la dette dans un conteneur plus récent.
Le critère qui tranche entre ces quatre stratégies : la stabilité de la logique concernée. Une règle qui ne bouge quasiment jamais (un calcul de TVA, une énumération de statuts) se prête bien à un socle partagé. Une règle encore vivante, retouchée à chaque sprint, finira tôt ou tard par diverger si elle est dupliquée, mieux vaut alors rappeler le monolithe, ou investir dans une vraie coupure interne avant d’extraire.
Dans tous les cas, une duplication temporaire n’a de sens que si elle a une date de péremption : un ticket, un commentaire explicite dans le code, et un critère de suppression rattaché à la phase Eliminate. Sans ça, la dette s’installe discrètement, et plus personne ne s’en souvient six mois plus tard.
10.Exemple détaillé : migrer le module Commandes avec YARP
L’exemple qui suit extrait le module Commandes vers un microservice conteneurisé, parce que c’est le cas le plus illustratif, et le plus demandé. Le pattern fonctionne pourtant à l’identique si la cible est un simple service ASP.NET Core déployé sur la même machine, ou même un module isolé dans une autre solution : ni la conteneurisation, ni un orchestrateur, ni une infrastructure dédiée ne sont des prérequis. La seule chose qui compte, c’est de pouvoir router une partie du trafic ailleurs que vers le monolithe.
10.1.Le système de départ
Prenons un cas classique : une plateforme e-commerce tourne sur un monolithe ASP.NET MVC (.NET Framework 4.8), qui gère catalogue, panier, commandes, facturation et compte client dans une seule solution, déployée sur IIS. L’équipe veut moderniser le module Commandes en .NET 10 (Minimal API, conteneurisée) sans toucher au reste, et sans coupure de service. L’objectif : extraire proprement, avec un filet de sécurité à chaque étape.
Un point à poser d’emblée, parce qu’il conditionne tout le reste : comme précisé en introduction, le front a déjà été remanié séparément sur une techno à part. Le monolithe ne sert donc ici que des endpoints API, c’est uniquement ce périmètre backend que la façade YARP et l’extraction concernent. La sous-section « Et le front ? » plus bas revient brièvement sur les conséquences pratiques de cette hypothèse, notamment côté authentification.
10.2.Introduire YARP comme façade unique
Avant même d’écrire une ligne du futur service, on installe YARP devant le monolithe. YARP (Yet Another Reverse Proxy) est développé par l’équipe ASP.NET de Microsoft et s’intègre nativement au pipeline ASP.NET Core, pas un binaire à opérer à côté comme Nginx ou Envoy, mais une bibliothèque .NET pilotable en C#, avec rechargement de configuration à chaud, health checks et équilibrage de charge intégrés.
À ce stade, tout le trafic va encore vers le monolithe : YARP ne fait rien de spectaculaire, il prend juste sa place. Une étape en apparence neutre, mais qui vaut la peine d’être déployée et validée seule avant d’y ajouter la moindre logique de routage.
Neutre, vraiment ? C’est précisément le piège principal de cette étape. En intercalant un proxy, le monolithe ne voit plus le client : il voit la façade. RemoteIpAddress devient l’adresse de YARP, le scheme peut passer de https à http si la terminaison TLS s’arrête sur la façade, et le Host devient celui de la destination interne. Les conséquences sont très concrètes : redirections absolues qui renvoient l’utilisateur vers monolith.internal, liens générés par Url.Action cassés, cookies émis sur le mauvais domaine, journaux applicatifs où toutes les requêtes semblent venir de la même IP, et règles anti-fraude ou de throttling basées sur l’IP qui deviennent aveugles du jour au lendemain.
YARP transmet bien X-Forwarded-For, X-Forwarded-Proto et X-Forwarded-Host, encore faut-il que le legacy les lise. En ASP.NET Core, c’est le middleware UseForwardedHeaders, à configurer avec les réseaux de confiance. En .NET Framework derrière IIS, il faut soit le module ARR avec les règles de réécriture correspondantes, soit une lecture explicite de ces en-têtes dans l’application. À vérifier avant d’envoyer le moindre trafic réel, c’est exactement la raison pour laquelle cette étape mérite une mise en production à elle seule.
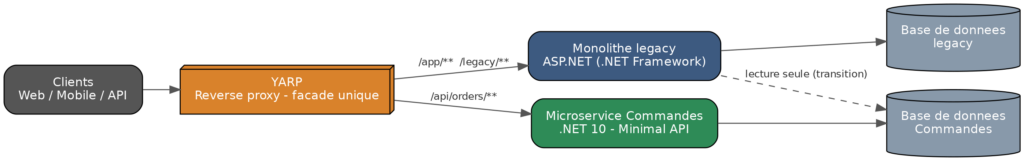 Architecture cible : YARP sert de façade unique entre les clients, le monolithe legacy et les microservices extraits.
Mise en place minimale :
dotnet new web -n Gateway.Yarp
cd Gateway.Yarp
dotnet add package Yarp.ReverseProxy
Program.cs :
var builder = WebApplication.CreateBuilder(args);

builder.Services
    .AddReverseProxy()
    .LoadFromConfig(builder.Configuration.GetSection("ReverseProxy"));

var app = builder.Build();

app.MapReverseProxy();

app.Run();
appsettings.json, état initial, tout vers le monolithe :
{
  "ReverseProxy": {
    "Routes": {
      "legacy-catch-all": {
        "ClusterId": "legacy-monolith",
        "Match": { "Path": "{**catch-all}" }
      }
    },
    "Clusters": {
      "legacy-monolith": {
        "Destinations": {
          "destination1": { "Address": "https://monolith.internal/" }
        },
        "HealthCheck": {
          "Active": { "Enabled": true, "Interval": "00:00:10", "Path": "/health" }
        }
      }
    }
  }
}
10.3.Extraire le module Commandes et router vers lui
Une fois la façade stabilisée, l’équipe développe order-service en .NET 10 (Minimal API), avec sa propre base ou, en phase de transition, un accès en lecture à l’existant. Le nouveau service expose les mêmes contrats que ceux déjà consommés sur /api/orders/**.
On ajoute une route dédiée dans YARP, avec un Order plus faible, donc plus prioritaire, c’est la valeur la plus basse qui gagne chez YARP, que le catch-all, et un transform pour ajuster le chemin. On omet ici le health-check et les autres options de cluster déjà vues à l’étape précédente, pour la lisibilité :
{
  "ReverseProxy": {
    "Routes": {
      "orders-route": {
        "ClusterId": "order-service",
        "Order": 1,
        "Match": { "Path": "/api/orders/{**remainder}" },
        "Transforms": [
          { "PathRemovePrefix": "/api/orders" }
        ]
      },
      "legacy-catch-all": {
        "ClusterId": "legacy-monolith",
        "Order": 100,
        "Match": { "Path": "{**catch-all}" }
      }
    },
    "Clusters": {
      "order-service": {
        "Destinations": {
          "destination1": { "Address": "https://order-service.internal/" }
        }
      },
      "legacy-monolith": {
        "Destinations": {
          "destination1": { "Address": "https://monolith.internal/" }
        }
      }
    }
  }
}
À partir de là, /api/orders/** part vers le nouveau service .NET 10, en toute transparence pour le client, le reste continue d’atterrir sur le monolithe. Le champ Order fixe l’ordre d’évaluation : la route dont la valeur est la plus basse est examinée en premier, et YARP retient la première qui correspond. Les routes spécifiques doivent donc toujours porter un Order inférieur à celui du catch-all.
10.4.Verrouiller le contrat avant d’envoyer le moindre trafic
Avant de laisser passer la moindre requête réelle vers order-service, encore faut-il être sûr qu’il répond comme l’ancien code : mêmes champs, mêmes codes d’erreur, mêmes formats de date. Un test de contrat (Pact, ou plus simplement une suite de tests d’intégration partagée) fige ce que le consommateur, le front-end, ou le monolithe lui-même, attend de l’API Commandes, et casse la build si le nouveau service s’en écarte.
Pas besoin d’un outillage sophistiqué pour démarrer : un jeu de requêtes/réponses de référence, capturées depuis le legacy, rejouées contre le nouveau service en CI, suffit à détecter la majorité des régressions de contrat avant qu’un utilisateur ne les découvre à votre place.
10.5.Authentification pendant la coexistence
Un détail qui coince souvent : le monolithe authentifie ses utilisateurs par cookie (ASP.NET Forms Authentication ou équivalent), pendant que le nouveau service attend un JWT en bonne et due forme. Pas question de faire ressaisir un mot de passe à chaque saut entre ancien et nouveau système, ni de dupliquer toute la logique d’authentification côté microservice.
La solution la plus rapide à mettre en place : la façade fait le pont. Elle identifie l’utilisateur à partir de la session legacy, puis émet un token à courte durée de vie qu’elle transmet au nouveau service via l’en-tête Authorization. Le microservice, lui, ne connaît que le JWT, il n’a jamais à se soucier de l’existence du legacy.
Attention toutefois à un raccourci qu’on lit un peu partout : une application ASP.NET Core ne lit pas nativement un cookie Forms Authentication émis par .NET Framework 4.8. Les deux mondes ne partagent ni le format du ticket, ni le mécanisme de protection des données. Deux options réalistes : le paquet Microsoft.Owin.Security.Interop côté legacy, avec un trousseau Data Protection partagé entre les deux applications, ou bien une page de bridge côté monolithe qui échange le cookie legacy contre un token émis par le nouveau service. Tant que l’un des deux n’est pas en place, HttpContext.User est tout simplement vide côté façade, et le transform ci-dessous ne fait rien.
// tokenIssuer : service enregistré au démarrage. Clé de signature, émetteur e
// durée de vie sont lus depuis la configuration, jamais codés en dur :
// "Auth": { "Issuer": "https://gateway.internal", "Audience": "order-service",
// "SigningKey": "", "Lifetime": "00:05:00" }
builder.Services.Configure<AuthOptions>(builder.Configuration.GetSection("Auth"));
builder.Services.AddSingleton<ITokenIssuer, JwtTokenIssuer>();
builder.Services.AddReverseProxy()
    .LoadFromConfig(builder.Configuration.GetSection("ReverseProxy"))
    .AddTransforms(context =>
    {
        context.AddRequestTransform(async transformContext =>
        {
            // 1. On supprime TOUJOURS l'en-tete Authorization entrant, en premier.
            // Un jeton fourni par le client ne doit jamais etre proxifie tel quel :
            // sinon n'importe qui peut forger un JWT et le faire relayer.
            transformContext.ProxyRequest.Headers.Authorization = null;

            // 2. On ne le reemet que si la facade a bien authentifie l'utilisateur.
            var legacyUser = transformContext.HttpContext.User;
            if (legacyUser.Identity?.IsAuthenticated == true)
            {
                var tokenIssuer = transformContext.HttpContext.RequestServices
                    .GetRequiredService<ITokenIssuer>();

                var jwt = await tokenIssuer.IssueTokenForAsync(legacyUser);
                transformContext.ProxyRequest.Headers.Authorization =
                    new AuthenticationHeaderValue("Bearer", jwt);
            }
        });
    });
| Approche | Quand l’utiliser |
| Token exchange à la façade | Solution rapide, ne touche pas au legacy. Bon point de départ pour la première extraction. |
| Fournisseur d’identité central en amont | Vision long terme, plusieurs modules à extraire dans la durée. Chantier plus lourd, mais évite la double gestion d’identités. |
| Propagation de claims enrichie | Le nouveau service a besoin de plus que l’identité brute : rôles, tenant, permissions fines. |
Quelle que soit l’option, le legacy garde son authentification interne intacte : seul le trafic sortant vers les nouveaux services passe par cette transformation. Et dans tous les cas, order-service doit valider lui-même la signature, l’émetteur et l’audience du token qu’il reçoit : la façade n’est pas, à elle seule, une frontière de sécurité suffisante.
10.6.Et le front ?
La question revient systématiquement en réunion : que devient l’interface pendant tout ça ? Réponse courte, rien, puisqu’elle a déjà changé de camp avant même le début de cet exemple. Le front, remanié sur sa techno propre, ne parle déjà plus qu’à des endpoints API, il n’a jamais consommé de vues Razor. Basculer /api/orders/** vers order-service ne change donc rien à ce qu’il ne voit ni à la manière dont il s’y connecte : c’est exactement le genre de bascule silencieuse que l’authentification par token, détaillée ci-dessus, rend possible.
Le seul vrai sujet résiduel, si le monolithe garde par ailleurs quelques vues legacy pour des écrans non encore repris par le nouveau front, est de bien circonscrire la façade YARP à /api/**, comme fait ici, pour ne pas mélanger un trafic HTML historique avec le routage API en cours de migration.
Le revers, à assumer dès le départ dans un projet de ce type : la migration décrite dans cet article, à elle seule, n’a aucun impact visible pour le sponsor. Aucune capture d’écran à projeter en comité de pilotage. La valeur est pourtant bien réelle, temps de réponse, taux d’erreur, délai de mise en production d’une évolution Commandes, fin de la dépendance à un framework en fin de vie, mais elle est invisible. D’où l’intérêt d’instrumenter tôt et de présenter ces métriques comme le livrable de la phase, plutôt que d’espérer un effet démo.
10.7.Valider en silence avec du traffic mirroring
Avant même d’envoyer le premier utilisateur réel vers order-service, il existe une étape encore plus prudente : dupliquer le trafic de production vers le nouveau service sans jamais renvoyer sa réponse au client. L’utilisateur continue de recevoir la réponse du monolithe, pendant qu’on compare les deux résultats en coulisses.
YARP ne propose pas ce mécanisme de façon native, il faut un middleware dédié qui, après avoir proxifié la requête vers le legacy, envoie une copie asynchrone (fire-and-forget) vers le nouveau service et journalise les écarts de réponse. Ce n’est pas gratuit : ça double la charge sur le nouveau service et ça demande une infrastructure de comparaison.
Et surtout, ce n’est pas anodin. Le mirroring est sûr sur les lectures, un GET dupliqué ne fait de mal à personne. Sur les écritures, c’est exactement l’inverse de l’intuition : dupliquer un POST vers un module de paiement ou de facturation, c’est déclencher un double débit ou une double facture, en vrai, sur de vrais clients. Un module à fort enjeu est donc le pire candidat à un mirroring naïf, pas le meilleur.
Pour miroiter des écritures, il faut d’abord que le service shadow tourne en mode sans effet de bord : un flag dry-run qui court-circuite les commits, une base de données jetable, la sandbox du prestataire de paiement plutôt que sa production, et des connecteurs externes (mail, ERP, transporteur) remplacés par des mocks. Tant que cette isolation n’est pas démontrée, et testée, mieux vaut limiter le mirroring aux lectures et valider les écritures autrement, par tests de contrat et bascule progressive.
10.8.Basculer progressivement avec un canary release
Basculer 100 % du trafic dès le premier déploiement, c’est tentant mais risqué. Plus prudent : cibler d’abord un tenant pilote ou un segment restreint, avant de généraliser. YARP sait matcher une route sur un en-tête en plus du chemin :
{
  "orders-canary": {
    "ClusterId": "order-service",
    "Order": 0,
    "Match": {
      "Path": "/api/orders/{**remainder}",
      "Headers": [
        { "Name": "X-Beta-Tenant", "Values": [ "true" ], "Mode": "ExactHeader" }
      ]
    },
    "Transforms": [ { "PathRemovePrefix": "/api/orders" } ]
  }
}
Un avertissement sur cet exemple, volontairement simplifié : X-Beta-Tenant est un en-tête fourni par le client. N’importe qui peut l’ajouter à sa requête et s’inscrire tout seul au canary, ou, avec un outil de test, y inscrire beaucoup de monde d’un coup. C’est acceptable pour une validation interne derrière un réseau privé, jamais sur une façade exposée.
En production, l’appartenance au canary se décide côté serveur. Deux formes courantes : une liste de tenants pilotes en configuration, rechargée à chaud, ou un claim vérifié dans le token émis par la façade après authentification. Dans les deux cas, la façade supprime systématiquement l’en-tête fourni par le client, puis réécrit elle-même l’en-tête de routage à partir d’une information qu’elle a validée, exactement la même logique que pour l’en-tête Authorization vu plus haut.
Pour un vrai pourcentage plutôt qu’un ciblage explicite (canary 90/10 classique), YARP ne propose pas de pondération prête à l’emploi sur une même route : il faut une ILoadBalancingPolicy maison, ou déléguer la décision à une couche en amont (feature flag, API Management…). Dans la plupart des migrations Strangler Fig, cibler un tenant ou un segment suffit largement, et c’est bien plus simple à auditer qu’un pourcentage aléatoire.
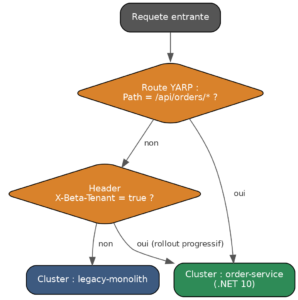 Logique de routage YARP combinant chemin et en-tête pour un déploiement canary progressif.
10.9.Résilience de la façade : fallback automatique
Jusqu’ici, la bascule vers le legacy en cas de souci est manuelle : on modifie une route. Une façade digne de ce nom doit aussi savoir réagir seule quand le nouveau service a un problème passager, sans attendre qu’un humain se réveille.
YARP sait retirer tout seul une destination défaillante à l’intérieur d’un même cluster, grâce aux health checks actifs déjà vus plus haut. Ce qu’il ne fait pas nativement, c’est basculer d’un cluster vers un autre, passer de order-service à legacy-monolith reste une décision métier, pas un simple équilibrage de charge. Pour l’automatiser, il faut un middleware de fallback : intercepter l’échec (timeout, erreur 5xx, circuit ouvert) et rejouer la requête contre le cluster legacy avant de répondre au client.
Inutile en revanche d’écrire la partie détection à la main. Microsoft.Extensions.Http.Resilience, la brique .NET bâtie sur Polly, s’attache au HttpClient utilisé pour les appels sortants et fournit timeout, retry et circuit breaker dans un pipeline standard, configurable et instrumenté. Le circuit breaker ouvre après un seuil d’échecs, le timeout borne l’attente, et le middleware de fallback n’a plus qu’à décider où rejouer la requête quand le circuit est ouvert.
// Pipeline de resilience (timeout + retry + circuit breaker) applique au
// HttpClient sortant de la facade. Base sur Polly, integre a .NET.
builder.Services.AddHttpClient("order-service")
    .AddStandardResilienceHandler(options =>
    {
        options.AttemptTimeout.Timeout = TimeSpan.FromSeconds(3);
        options.Retry.MaxRetryAttempts = 2;
        options.CircuitBreaker.FailureRatio = 0.5;
        options.CircuitBreaker.BreakDuration = TimeSpan.FromSeconds(30);
    });
C’est la même règle que partout ailleurs dans cet article : on ne réinvente pas la roue. Circuit breaker, retry et timeout sont des briques standard, testées et supervisées par d’autres, l’énergie de l’équipe doit aller sur le métier extrait, pas sur une réimplémentation maison de la résilience.
Côté configuration YARP, les health checks et le timeout d’activité complètent le dispositif :
{
  "order-service": {
    "Destinations": {
      "primary": { "Address": "https://order-service.internal/" }
    },
    "HealthCheck": {
      "Active": {
        "Enabled": true,
        "Interval": "00:00:05",
        "Timeout": "00:00:02",
        "Path": "/health"
      }
    },
    "HttpRequest": {
      "ActivityTimeout": "00:00:03"
    }
  }
}
Un bémol à garder en tête : ce filet de sécurité est plus confortable en lecture qu’en écriture. Une commande qui échoue à moitié sur le nouveau service avant de retomber sur le legacy risque d’être traitée deux fois. Le fallback automatique est donc surtout pertinent pour les opérations idempotentes ou en lecture seule, pour les écritures critiques, mieux vaut un circuit breaker qui coupe proprement, une erreur claire renvoyée au client plutôt qu’un rattrapage silencieux et potentiellement dangereux.
10.10.Gérer les données pendant la transition
Le routage HTTP, c’est la partie facile. Le vrai sujet, c’est la cohérence des données pendant que les deux systèmes cohabitent, et c’est de loin la partie la plus coûteuse, la plus lente et la plus risquée d’une migration Strangler Fig.
Point de départ typique : le monolithe possède une base unique, où les commandes vivent aux côtés du catalogue, des clients et des factures, reliés par des clés étrangères et interrogés à coups de jointures. La cible, elle, est une base par bounded context, avec un schéma pensé pour le nouveau service, surtout pas une copie du schéma legacy, sinon on récupère la dette avec les données. Entre les deux, une période de coexistence qu’il faut décrire précisément avant de commencer :
| Étape | Topologie des données |
| Avant extraction | Monolithe MVC → une base SQL Server unique : Orders, Customers, Products, Invoices dans le même schéma, contraintes d’intégrité et jointures entre toutes ces tables. |
| Pendant la coexistence | Monolithe MVC → base legacy (Customers, Products, Invoices, et des tables Orders qui ne sont plus la référence). order-service → base Commandes, schéma dédié et modèle propre. Entre les deux, un flux de synchronisation dans un sens clairement défini, plus des données référentielles (client, produit) soit répliquées en lecture, soit résolues par appel au monolithe à travers l’anti-corruption layer. |
| Après élimination | order-service → base Commandes, seule source de vérité. Le flux de synchronisation, les tables Orders legacy et les jobs batch associés sont supprimés : c’est un livrable de la phase Eliminate, pas un détail d’intendance. |
Le point à ne pas sous-estimer : ce n’est pas « une base contre une base », c’est un schéma monolithique contre plusieurs schémas hétérogènes, chacun avec ses propres identifiants, ses propres types et son propre vocabulaire. La correspondance entre les deux est du code à écrire, à tester et à maintenir pendant toute la coexistence.
Trois approches pour tenir la cohérence pendant cette période, souvent combinées :
- Lecture seule miroir : le nouveau service lit l’ancienne base en attendant d’avoir la sienne. Simple à mettre en place, mais il reste couplé au schéma legacy, et toute évolution de ce schéma le casse.
- Double écriture (dual write) : chaque système écrit dans sa propre base. Efficace sur le papier, mais sans garde-fou les deux bases finissent systématiquement par diverger, généralement au premier incident réseau survenu entre les deux écritures.
- Capture de changements : on capte les modifications côté legacy et on les rejoue côté nouveau service, sans écriture croisée. C’est l’approche la moins intrusive pour le monolithe, mais elle introduit un décalage à assumer.
La « rigueur » que réclame la double écriture porte un nom : le pattern Transactional Outbox . Le principe : dans la même transaction locale que l’écriture métier, on insère l’événement correspondant dans une table outbox de la même base. La transaction garantit que les deux réussissent ou échouent ensemble. Un processus séparé lit ensuite cette table et publie les événements vers le bus, avec réessai jusqu’à confirmation puis marquage. On échange une cohérence immédiate contre une cohérence à terme, mais fiable, alors qu’une double écriture naïve (écrire en base, puis publier sur le bus) n’offre ni l’une ni l’autre dès que le processus tombe entre les deux opérations. Sans outbox, ou équivalent, une double écriture finit toujours par diverger : la seule inconnue est la date.
Sur SQL Server, deux fonctionnalités sont par ailleurs régulièrement confondues alors qu’elles ne répondent pas du tout au même besoin :
| Mécanisme | Ce qu’il fournit réellement |
| Change Tracking (CT) | Indique quelles lignes ont changé et par quelle opération (insert, update, delete). Léger, peu coûteux, disponible en édition Standard. En revanche il ne conserve pas les valeurs : pour connaître le contenu, il faut relire la ligne courante. Aucun historique, donc aucune capacité de rejeu. |
| Change Data Capture (CDC) | Capture le contenu complet de chaque changement (valeurs avant et après) dans des tables alimentées depuis le journal des transactions. Plus lourd à exploiter (agent SQL, rétention, purge), mais c’est le seul des deux qui permet de reconstituer et de rejouer une séquence de changements, et c’est ce que consomment les outils de type Debezium. |
En résumé : Change Tracking pour savoir quoi resynchroniser, Change Data Capture pour produire un flux d’événements fidèle. Un pipeline de migration qui a besoin de rejouer l’historique a besoin de CDC, pas de CT, les confondre au moment du chiffrage se paie plus tard.
Reste le vrai morceau : la transactionnalité. Tant que tout vit dans la même base, « créer la commande, décrémenter le stock, générer la facture » tient dans une transaction unique, et un simple rollback annule proprement l’ensemble. Dès que les commandes partent dans une autre base, cette garantie disparaît. Il n’existe pas de remplaçant magique : le transactionnel distribué à l’ancienne (MSDTC, validation en deux phases) ne passe pas l’échelle et ne s’applique pas à des services hétérogènes déployés séparément.
Ce qui le remplace, c’est un travail de conception, pas une bibliothèque : découper l’opération en étapes compensables (pattern Saga), rendre chaque étape idempotente pour pouvoir la rejouer sans dégât, et accepter des états intermédiaires visibles par le métier, « commande créée, facturation en attente ». C’est bien plus qu’un sujet technique : il faut faire valider par le métier qu’une commande puisse exister quelques secondes sans facture, et décider de ce qui se passe quand la compensation échoue à son tour. Router une API se fait en une après-midi, redessiner une frontière transactionnelle se négocie sur plusieurs sprints.
Un mot enfin sur la façade elle-même. En MVC classique, l’action du contrôleur porte souvent la transaction globale de bout en bout. YARP, dans cet article, est une façade de routage pure : pas un BFF, pas un orchestrateur. Elle ne compose rien, n’agrège rien, et ne doit surtout pas devenir l’endroit où l’on recoud discrètement une transaction éclatée. Si un besoin d’agrégation inter-services apparaît (un écran qui réclame la commande et la facture en un seul appel), il se traite dans un composant dédié, conçu et testé comme tel, pas en glissant de la logique métier dans le proxy.
Le bon choix dépend donc du couplage transactionnel avec le reste du monolithe : plus les tables sont partagées et plus les opérations traversent les frontières, plus il faut investir tôt dans la capture de changements, l’outbox et les sagas, et plus il faut être honnête, dès le budget initial, sur le coût de cette partie-là.
10.11.Basculer complètement et retirer le legacy
Quand 100 % du trafic Commandes passe par le nouveau service, et que ça tient la route sur plusieurs cycles métier (facturation, pics de charge…), on retire la route canary, on simplifie la config YARP, puis on supprime le code, les tables et les jobs batch devenus inutiles côté legacy.
C’est la phase Eliminate , la première sacrifiée quand les priorités changent. À tort : un legacy à moitié vidé mais toujours déployé, c’est le pire des deux mondes. Budgétez-la comme le reste.
 Chronologie type d’une migration Strangler Fig, de l’ajout de la façade à la suppression du code legacy.
11.Observabilité : suivre la migration de bout en bout
Avec onze étapes, deux systèmes, une façade et des règles de routage qui évoluent chaque semaine, une chose devient vite non négociable : voir ce qui se passe. Trois piliers suffisent pour la plupart des migrations Strangler Fig :
- Corrélation : un identifiant de requête généré (ou propagé) par YARP, transmis en en-tête à travers le monolithe et les microservices, pour reconstituer le parcours complet d’une requête qui a traversé les deux mondes.
- Métriques par cluster : taux d’erreur, latence, volumétrie, comparés en continu entre legacy-monolith et order-service, pour repérer un écart avant qu’il ne devienne un incident.
- Traces distribuées : OpenTelemetry, désormais supporté nativement par ASP.NET Core et YARP, permet de visualiser un aller-retour façade → microservice → base de données dans un seul et même diagramme de trace, sans grep désespéré dans quatre fichiers de logs différents.
builder.Services.AddOpenTelemetry()
    .WithTracing(tracing => tracing
        .AddAspNetCoreInstrumentation()
        .AddHttpClientInstrumentation()
        .AddSource("Yarp.ReverseProxy")
        .AddOtlpExporter());
Sans cette instrumentation, chaque incident de migration se transforme en séance de spéléologie dans les logs. Avec elle, on sait en quelques minutes si le problème vient du legacy, du nouveau service, ou de la façade elle-même. Et, comme évoqué plus haut, ce sont ces métriques qui constituent le livrable visible d’une phase où le front, lui, ne bouge pas.
12.Variante : quand le monolithe carbure aux événements
Tout l’exemple précédent suppose un monolithe qui parle HTTP. Beaucoup de systèmes plus anciens fonctionnent aussi, ou uniquement, par événements internes : un module publie OrderCreated, un autre l’écoute pour décrémenter un stock ou déclencher une facture. Router du HTTP ne suffit alors pas à étrangler grand-chose.
Le principe reste identique, seul le point d’interception change : au lieu, ou en plus, d’une façade HTTP, on place le nouveau service en tant que consommateur du même bus d’événements. Il commence par écouter en silence (l’équivalent événementiel du traffic mirroring), puis reprend progressivement la responsabilité de certains handlers, pendant que le monolithe cesse, module par module, de les traiter lui-même.
Concrètement, la difficulté n’est pas de brancher un consommateur .NET 10, c’est un BackgroundService assez classique, mais de le faire lire une copie des événements sans perturber les consommateurs existants. Chaque broker a sa propre façon d’isoler cette lecture en miroir :
| Broker | Comment isoler la lecture en miroir |
| Azure Service Bus | Créer une subscription dédiée sur le topic existant : chaque subscription reçoit sa propre copie de chaque message, sans toucher à celle du legacy. |
| RabbitMQ | Déclarer une queue dédiée liée au même exchange (fanout ou topic) : chaque queue reçoit sa propre copie, indépendamment des autres consommateurs. |
| Kafka | Utiliser un consumer group distinct : chaque groupe relit le topic à son propre rythme, sans interférer avec les autres. |
12.1.Azure Service Bus
Le nouveau service ouvre un processeur sur une subscription qui lui est propre ( order-service-shadow ), branchée sur le topic déjà utilisé par le monolithe :
var client = new ServiceBusClient(connectionString);

var processor = client.CreateProcessor("orders-topic", "order-service-shadow",
    new ServiceBusProcessorOptions { AutoCompleteMessages = false });

processor.ProcessMessageAsync += async args =>
{
    var orderCreated = args.Message.Body.ToObjectFromJson<OrderCreatedEvent>();
    await orderHandler.HandleAsync(orderCreated);
    await args.CompleteMessageAsync(args.Message);
};

processor.ProcessErrorAsync += args =>
{
    logger.LogError(args.Exception, "Erreur de traitement du message");
    return Task.CompletedTask;
};

await processor.StartProcessingAsync();
12.2.RabbitMQ
Même logique côté RabbitMQ : une queue dédiée, liée à l’exchange existant, sans jamais modifier la configuration consommée par le legacy. L’API est entièrement asynchrone depuis la version 7 du client, les anciens CreateModel, IModel, BasicPublish et EventingBasicConsumer ont disparu :
// API RabbitMQ.Client v7+
var factory = new ConnectionFactory { HostName = "rabbitmq.internal" };
await using var connection = await factory.CreateConnectionAsync();
await using var channel = await connection.CreateChannelAsync();await channel.QueueDeclareAsync("order-service-shadow", durable: true,
    exclusive: false, autoDelete: false);

await channel.QueueBindAsync("order-service-shadow", exchange: "orders",
    routingKey: "order.created");

// IAsyncBasicConsumer : le handler est attendu, plus de void async
var consumer = new AsyncEventingBasicConsumer(channel);

consumer.ReceivedAsync += async (sender, ea) =>
{
    var orderCreated = JsonSerializer.Deserialize<OrderCreatedEvent>(ea.Body.Span);
    await orderHandler.HandleAsync(orderCreated!);
    await channel.BasicAckAsync(ea.DeliveryTag, multiple: false);
};

await channel.BasicConsumeAsync("order-service-shadow", autoAck: false, consumer);

// Publication cote nouveau service, une fois la responsabilite reprise
await channel.BasicPublishAsync(exchange: "orders", routingKey: "order.validated",
    body: JsonSerializer.SerializeToUtf8Bytes(orderValidated));
12.3.Kafka
Sur Kafka, le consumer group fait tout le travail d’isolation : un identifiant de groupe dédié suffit à relire le topic depuis le début, indépendamment des consommateurs déjà en place :
var config = new ConsumerConfig
{
    BootstrapServers = "kafka.internal:9092",
    GroupId = "order-service-shadow",
    AutoOffsetReset = AutoOffsetReset.Earliest
};
using var consumer = new ConsumerBuilder<string, string>(config).Build();
consumer.Subscribe("orders.created");while (!cancellationToken.IsCancellationRequested)
{
    var result = consumer.Consume(cancellationToken);
    var orderCreated = JsonSerializer.Deserialize(result.Message.Value);
    await orderHandler.HandleAsync(orderCreated!);
}
Une fois la lecture en miroir validée (résultats comparés, aucune divergence sur quelques cycles métier), la bascule se fait côté publication ou côté abonnement selon les cas : on désactive le handler legacy pour cet événement précis, et le nouveau service devient le seul responsable, sans jamais avoir touché à la façade YARP.
Trois points de vigilance restent valables quel que soit le broker : la compatibilité de schéma des événements (un champ ajouté ou renommé casse tous les consommateurs, legacy comme nouveaux, un registre de schémas ou un versionnage explicite évite bien des surprises), l’idempotence des handlers (un événement peut être livré plusieurs fois, stocker les identifiants déjà traités, table dédiée ou cache à durée de vie courte, protège contre le double traitement), et l’ordre de livraison (garanti par partition sur Kafka, par file sur RabbitMQ et Service Bus, à condition de bien choisir la clé de partition ou de session dès le départ).
13.Checklist avant de se lancer
Une dernière chose avant le grand saut : une grille d’auto-évaluation, pour vérifier que le terrain est prêt plutôt que de le découvrir en production.
- Un sponsor identifié, capable de tenir la distance sur plusieurs mois, voire années, sans perdre patience à la première itération, et à qui on a présenté un ordre de grandeur honnête plutôt qu’une promesse de trois mois.
- Un premier module cartographié avec une frontière métier nette, une valeur business visible et un risque technique maîtrisé, choisi aussi pour roder l’outillage, pas pour attaquer le cœur du réacteur d’entrée de jeu.
- Une stratégie de gestion des données tranchée pour ce module (lecture miroir, outbox, capture de changements) avant le premier déploiement réel, ainsi que le sort réservé aux opérations qui traversaient une transaction unique.
- Des tests de contrat automatisés en CI, pour détecter une régression avant qu’un utilisateur ne le fasse à votre place.
- Une façade traitée comme un service de production à part entière : haute disponibilité, alerting, runbook d’incident, pas un script qu’on laisse tourner dans un coin.
- Une configuration YARP versionnée comme du code, avec revue à chaque changement de route.
- Un plan de rollback écrit et rejoué au moins une fois à froid : repointer une route YARP doit être un geste banal et documenté, pas une opération improvisée un vendredi soir. Les en-têtes transférés (X-Forwarded-*) et le comportement du legacy derrière le proxy en font partie.
- Des critères de sortie explicites pour la phase Eliminate, trafic à 100 % sur le nouveau service, N cycles métier sans incident, code, tables et jobs batch legacy supprimés, budgétés au même titre que le développement du nouveau service.
- Une façade instrumentée, logs corrélés, métriques par cluster, traces distribuées, avant d’y faire transiter le moindre trafic réel.
Si la plupart de ces cases sont cochées, le terrain est prêt. Sinon, chaque case restée vide est un risque identifié, pas forcément bloquant, mais à traiter consciemment plutôt qu’à découvrir en production.
14.Conclusion
Le Strangler Fig ne fait pas disparaître la complexité d’une migration : il l’étale dans le temps et réduit le risque à chaque étape. Sur un monolithe .NET vieillissant, une façade YARP, légère, native, pilotable en C#, combinée à une extraction méthodique offre un chemin réaliste, testable en production, et réversible à tout moment.
La contrepartie est autant organisationnelle que technique : sans discipline sur la phase d’élimination, la coexistence prolongée coûte parfois plus cher que la réécriture qu’on voulait éviter. Bien mené, ce pattern permet de moderniser un système critique sans jamais avoir à l’arrêter.
15.Pour aller plus loin
- Martin Fowler, StranglerFigApplication
- Paul Hammant, Legacy Application Strangulation: Case Studies (2013)
- Martin Fowler, BoundedContext
- Microsoft Learn, Documentation YARP
- Microsoft Learn, Fichiers de configuration YARP
- Microsoft Learn, Résilience HTTP avec Microsoft.Extensions.Http.Resilience
- Microsoft Learn, Suivre les modifications : Change Tracking et Change Data Capture
- microservices.io, Transactional Outbox
- OpenTelemetry pour .NET
- Pact, Documentation des tests de contrat
- Dépôt GitHub dotnet/yarp
